最強模型不是每件事都該用:配額逼我重劃 AI 分工
省流:把 Fable 5(最強、但有配額上限的那顆)留在主線對話與最後求救,中間的所有派工一律依「需不需要判斷力」把模型與思考深度一起釘死。
50% 配額天花板撞牆現場
2026 年 7 月 20 日那天,官方改了配額政策。
我原本以為訂閱了高階方案,額度就是一大包隨便用。直到那天被系統硬生生擋下來,我才發現自己理解錯了。官方的旗艦模型 Fable 5(系列裡最強的一顆,下面依序是 Opus、Sonnet、Haiku),並不是另外給一份配額,而是被設了一條上限:在 Max 這類方案上,它的用量最多只能吃掉共用週額度的 50%。介面上它顯示成一條獨立的進度條,但扣的都是同一池。
意思是,如果你什麼都用它,總額度還剩近一半的時候,Fable 5 就已經先到頂停用了。
更陰險的是工具的預設行為。當你在 Claude Code 裡派一個子代理去做事、卻沒有指定模型時,它會預設繼承你主視窗的模型。如果你習慣主力用 Fable 5 聊天,那每一次隨手派出去的子代理,都在瘋狂消耗 Fable 5 那條 50% 的上限。
我的撞牆現場非常具體:討論到一半,最核心的計畫還沒拍板,Fable 5 就被額度擋下、接不下去了。當時我不敢把這種討論丟給更低階的模型,因為計畫階段就在整條工作流程的最上游,上游一歪後面全倒。最後急件也只敢降一階,硬著頭皮換 Opus(次一階的主力模型)接手,深度肉眼可見地下降;非急件的討論就擱著等額度重置,那段時間空出來的 Opus,就拿去消化不需要想太深的工作。
這逼我重新思考模型該怎麼分工。我原本的直覺是「重要的工作全部給最強模型」,但現實是這個直覺會讓你最快撞牆。真正該問的不是任務重不重要,而是這步到底需不需要判斷力。
官方方法論:誰決定何時借用智力
事後我翻了官方發表的方法論文章,發現官方把子代理的架構分成了方向相反的兩種模式。這些文章不是我的解法來源(分工是先重畫完才讀到它們的),但它們給了我一套事後對得上的座標系。
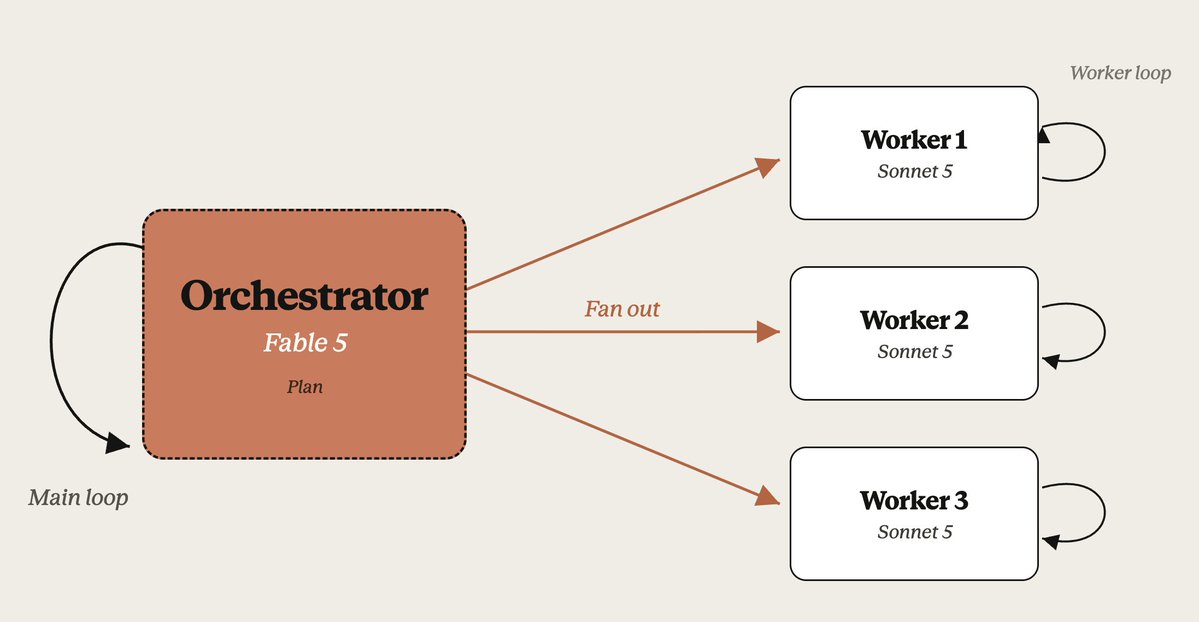
第一種是大家最常寫的 Orchestrator(協調者模式),出自 Building effective agents:由一個強的主模型從上而下拆解任務,派給便宜的工人模型去執行,最後再收攏結果。
 圖片出處:ClaudeDevs 的官方 X 貼文
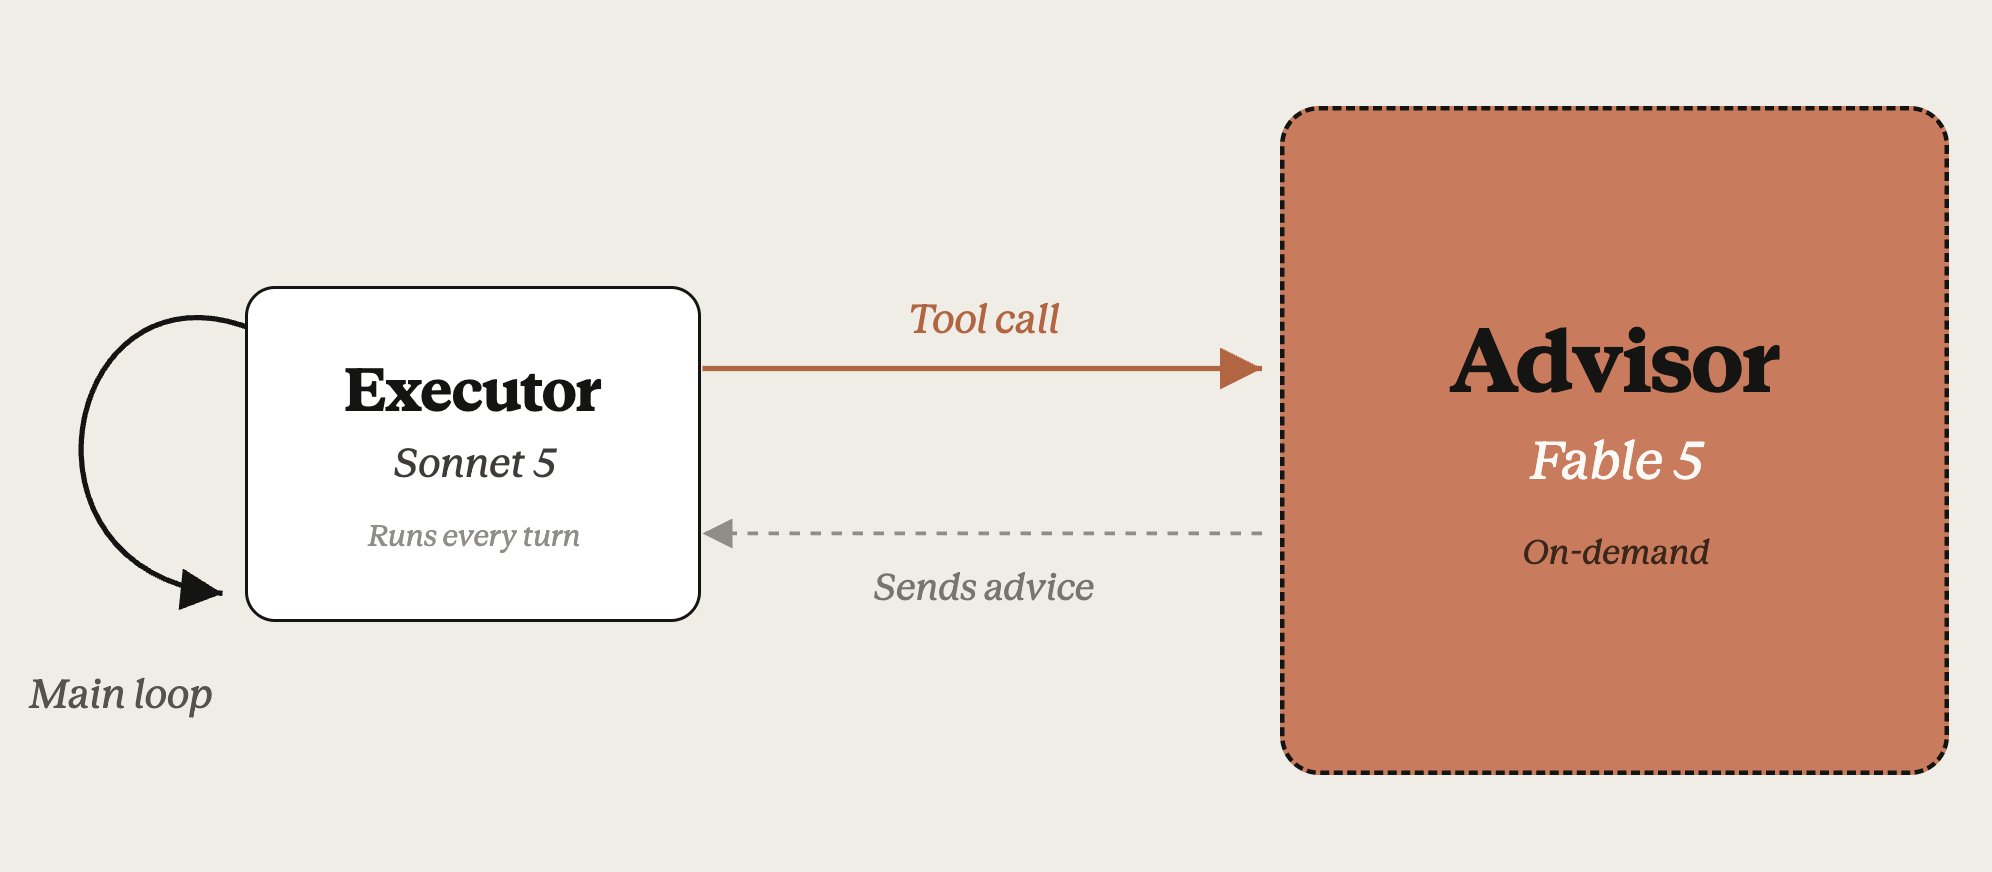
第二種則是 Advisor(顧問模式),出自 The advisor strategy:讓便宜的模型作為主要執行者一路往前做,碰到解決不了的卡關時,才向強模型喊一次救命,拿一份指引後繼續自己跑。順帶一提,這篇本身就是產品發布公告,官方的 advisor 是 API 上的伺服器端工具;至少七月底我實測時,訂閱制 Claude Code 上我的帳號還開不了它。
 圖片出處:ClaudeDevs 的官方 X 貼文
官方在 Advisor 的專文裡特別強調:顧問不呼叫工具,也不產出最終內容,它唯一的職責就是給執行者指引。這把「誰決定何時借用智力」的權利完全反過來了。
除了選型號,還有第二顆旋鈕:思考深度(effort)。
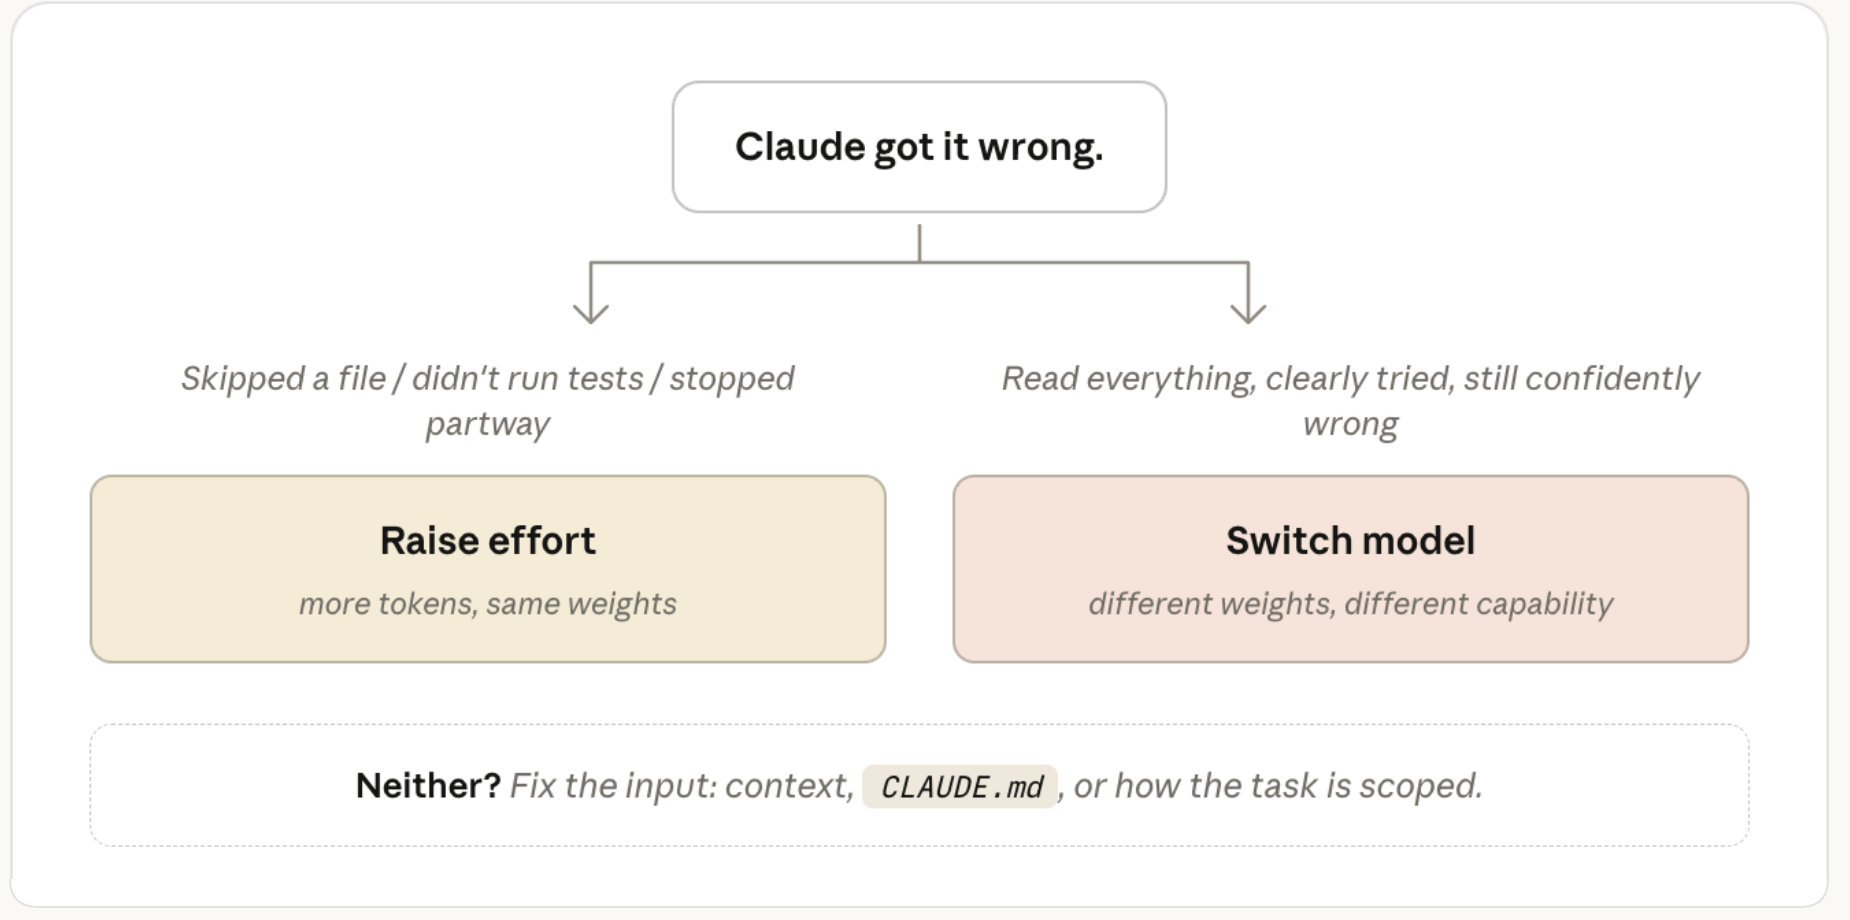
同一顆模型,你可以調整它想多深,深度總共五檔,由淺到深:low、medium、high、xhigh、max。這代表選模型不再是一維的排等級,而是二維的:型號一軸、深度一軸。官方在 Choosing a Claude model and effort level in Claude Code 給了一個很有意思的診斷決策圖:當模型答錯時,先問它是「不夠努力」還是「不夠懂」。
 圖片出處:Claude blog「Choosing a Claude model and effort level in Claude Code」
如果它跳過檔案、沒跑測試、做到一半就停,那是不夠努力,調高思考深度就好;如果該讀的都讀了、也真的動手試了,卻錯得非常有把握,那才是真的不夠懂,這時候才需要換更強的模型。官方文件甚至直接建議:只要你的評測守得住品質,應該把 low 跟 medium 當成控制成本與延遲的主旋鈕(前提是你真的有在驗品質,不是套了就走)。
任務分類:按性質,不按難度
回到我自己的分法。「需不需要判斷力」是第一刀:完全不需要的是機械活;需要的再看是照規格動手、還是要形成結論。這樣切出三類,外加一個跨類的修飾符,每一條把模型跟思考深度直接釘死:
第一類是機械活(翻譯、摘要、格式轉換)。給 Sonnet(便宜一階、輸出穩定),深度釘 low。
第二類是實作活(寫程式碼、多檔案改動、重構)。給 Opus,深度釘 medium。
第三類是判斷活(架構決策、邏輯驗證、對抗審查)。一樣給 Opus,但深度拉到 xhigh。
跨類的那個是安全敏感修飾符,優先權高於三類:不論原本屬哪一類,只要涉及金鑰、權限或安全性修改,一律事前指定 Opus 配 high。這不是因為能力不夠,而是各型號的安全把關敏感度不同:不事前釘死,工作做到一半落到把關較嚴的那顆,可能中途被拒答。
這裡面有一條最容易被看錯:探勘型任務(需要在一大片檔案裡快速掃描定位)。這類任務我用 Opus,但深度只給 low。前面那篇講型號與深度的官方文章,對這種用法的類比很精準:像花五分鐘請教一位見多識廣的資深專家。要的是他的經驗與眼界,五分鐘本來就只夠他快讀,不夠細讀。
你可能注意到這張分工表裡沒有 Fable 5。它只保留兩個入口:主線對話,跟升級鏈的最後一階。子代理派工一律不碰它。這條沒明寫在任何官方文件裡的規則,才是我這次不再提前撞牆的關鍵。
單一模型在不同層的三種待遇
任務性質之外,執行環境也會改變同一顆模型適不適用。最能說明這件事的例子,就是最便宜的 Haiku。我的派工有三個入口:即興派工(對話中臨時派子代理)、hook(掛在工具事件上的自動檢查腳本)、流程腳本(步驟寫死的自動化流水線)。同一顆 Haiku 在這三層拿到三種完全不同的待遇。
在即興派工層,它是全域禁用的,因為我不相信它在沒有約束的情況下能做對判斷;在 hook 層,評估後判定它確實適合做簡單的特徵判定,但實際部署量是零;但在流程腳本層,因為每一個步驟的輸入與輸出規格都被程式碼嚴格鎖死,它反而是執行紀錄裡實際跑量最大的模型(一段幾天的取樣期間,不是總量統計)。
結論不是「用不用它」,而是它被排除在所有需要判斷的入口外,只留在規格寫死、單點失敗可容忍的位置。
結構性參數勝過 Prompt 規則文字
這套規則如果只寫在文件裡,主視窗的模型聊著聊著就會忘掉。這跟我在第十五篇講的是同一件事:程式保證優於模型自律。
要讓它真的被執行,有兩種強制手段。最簡單也最便宜的招式,是在子代理定義檔開頭的設定區(frontmatter)直接釘死模型與思考深度。Claude Code 的派工介面本身沒有思考深度這個參數,寫在 prompt 裡只是哀求,寫在定義檔才是真正的結構性參數。
另一招比較重,是用一支 hook 腳本當派工閘門:子代理派工只要沒有顯式宣告模型與分類,直接擋掉。這支閘門是純規則腳本、本身不跑任何模型,跟前面 hook 層那個「用模型做特徵判定」的評估是兩回事。實測的 12 天期間內,以派工次數計,攔截率不到 5%。攔得少,反而表示規則平時有被遵守。它的定位就像保險絲,平時靜悄悄,價值在於你更換型號、或把整套分工搬到另一家模型的那一週。如果你平時派工頻率不高,靠定義檔釘死就完全夠用了;閘門是要維護的東西,別為低頻場景背這個成本。
第二意見:押手動,不押自動
失敗跟高風險決策的處理,我拆成兩層。
第一層是自動失敗升級:同一個問題最多兩次修正嘗試,過不了就逐級往上換模型,最後一階才是 Fable 5。這套機制聽起來很美,但 Claude Code 會把每一場對話跟派工留成紀錄檔,我拿這批紀錄掃了 35 天的觀察期:它觸發 Fable 5 那一階的次數,是完美的 0 次(中間那一階我沒驗過,只能說最頂那階從沒用上)。這條路我照樣留著(從沒被需要過,不代表要拆),但重心顯然不該押在這。
第二層則是人手動發起的第二意見(在定方案前、卡關時、或宣告完成前,手動叫別的模型來審查;多模型交叉審的細節在第十八篇寫過)。這層反而天天在用:光是最常用的一個第二意見機制,35 天內就出現在 97 個 session 裡,平均一天將近三場。
為什麼押手動而不押自動?官方 advisor 的方向我其實認同,差別只在誰扣扳機。官方讓執行者自己喊救命,但正在埋頭執行的那顆模型,得先判斷「我需不需要判斷力支援」,而這個問題本身就需要判斷力,遞迴了。由人在幾個固定節點手動扣扳機,可重現性高得多。
額度帳收束與行動建議
最後回頭算這筆額度帳。
我一開始也擔心,把機械活降級給便宜模型會不會不划算。實測下來,便宜模型因為理解力較弱,確實會多花一點重試的 token,總 token 量會小幅上升。但額度的粗算法就是 token 量乘上單價(訂閱額度內部怎麼加權沒有公開,我拿官方 API 標價當代理指標),機械活這段的單價差是數倍級,就算權重跟標價有出入,也蓋得掉那點 token 增量,整體額度是降的。
帳要用額度算,不能用 token 算。
品質那邊,我不做「降級零損失」的宣稱:有一組還在跑的影子對照(同一件審查讓降級後的 Opus 跟原本的 Fable 5 各跑一次、互相比對),目前第一階段的結論是互有勝負:兩邊都持續抓到對方沒抓到的問題,所以少數幾個審查環節我還保留雙跑。雙跑當然是雙倍成本,但那些本來就是我願意付雙倍的節點;省下來的是量大的機械活。
改制後的成果非常直觀:在最近一次的額度重置前夕,我的整體週額度用了 100%,Fable 5 對它自己那條 50% 上限也用到了 99%(兩個百分比各對各的分母算)。額度本來就是要用完的,問題從來不是用滿、是提前用滿:以前是 Fable 5 先死、總額度還剩近一半,現在是兩條同一週一起走到底。至少這一週是這樣;把這歸功於分工,是我自己的判讀。
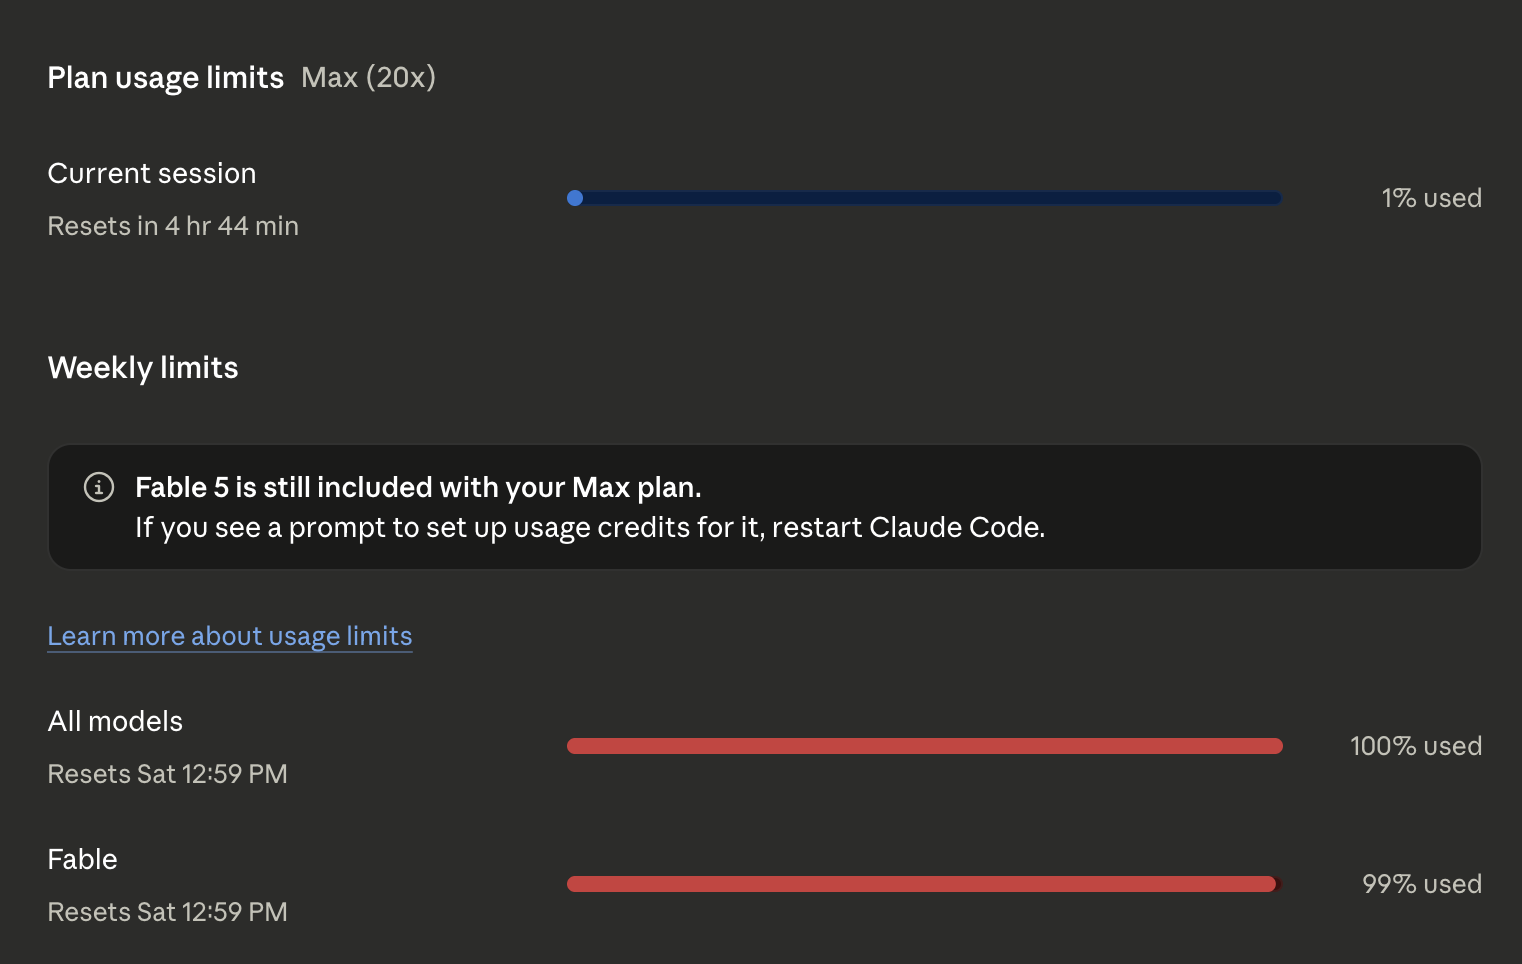 額度重置前夕的實況:整體 100%、Fable 5 那條上限 99%(2026 年 8 月截圖)
如果你明天也想調整你的 AI 分工,有三件事可以立刻做:
- 先把最強的那顆留給主線對話與最後升級;每次派工前,再問這步是機械、實作還是判斷。
- 把模型與思考深度直接寫死在子代理定義檔的設定區。
- 遇到高風險的決策,不要依賴自動升級,手動叫一次第二意見。